Zum Inhalt springen
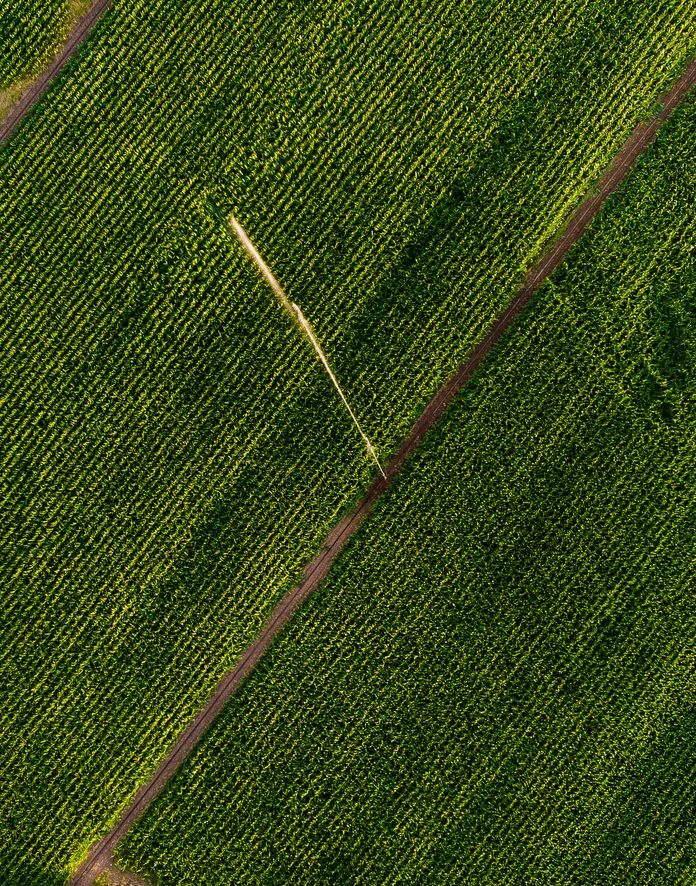
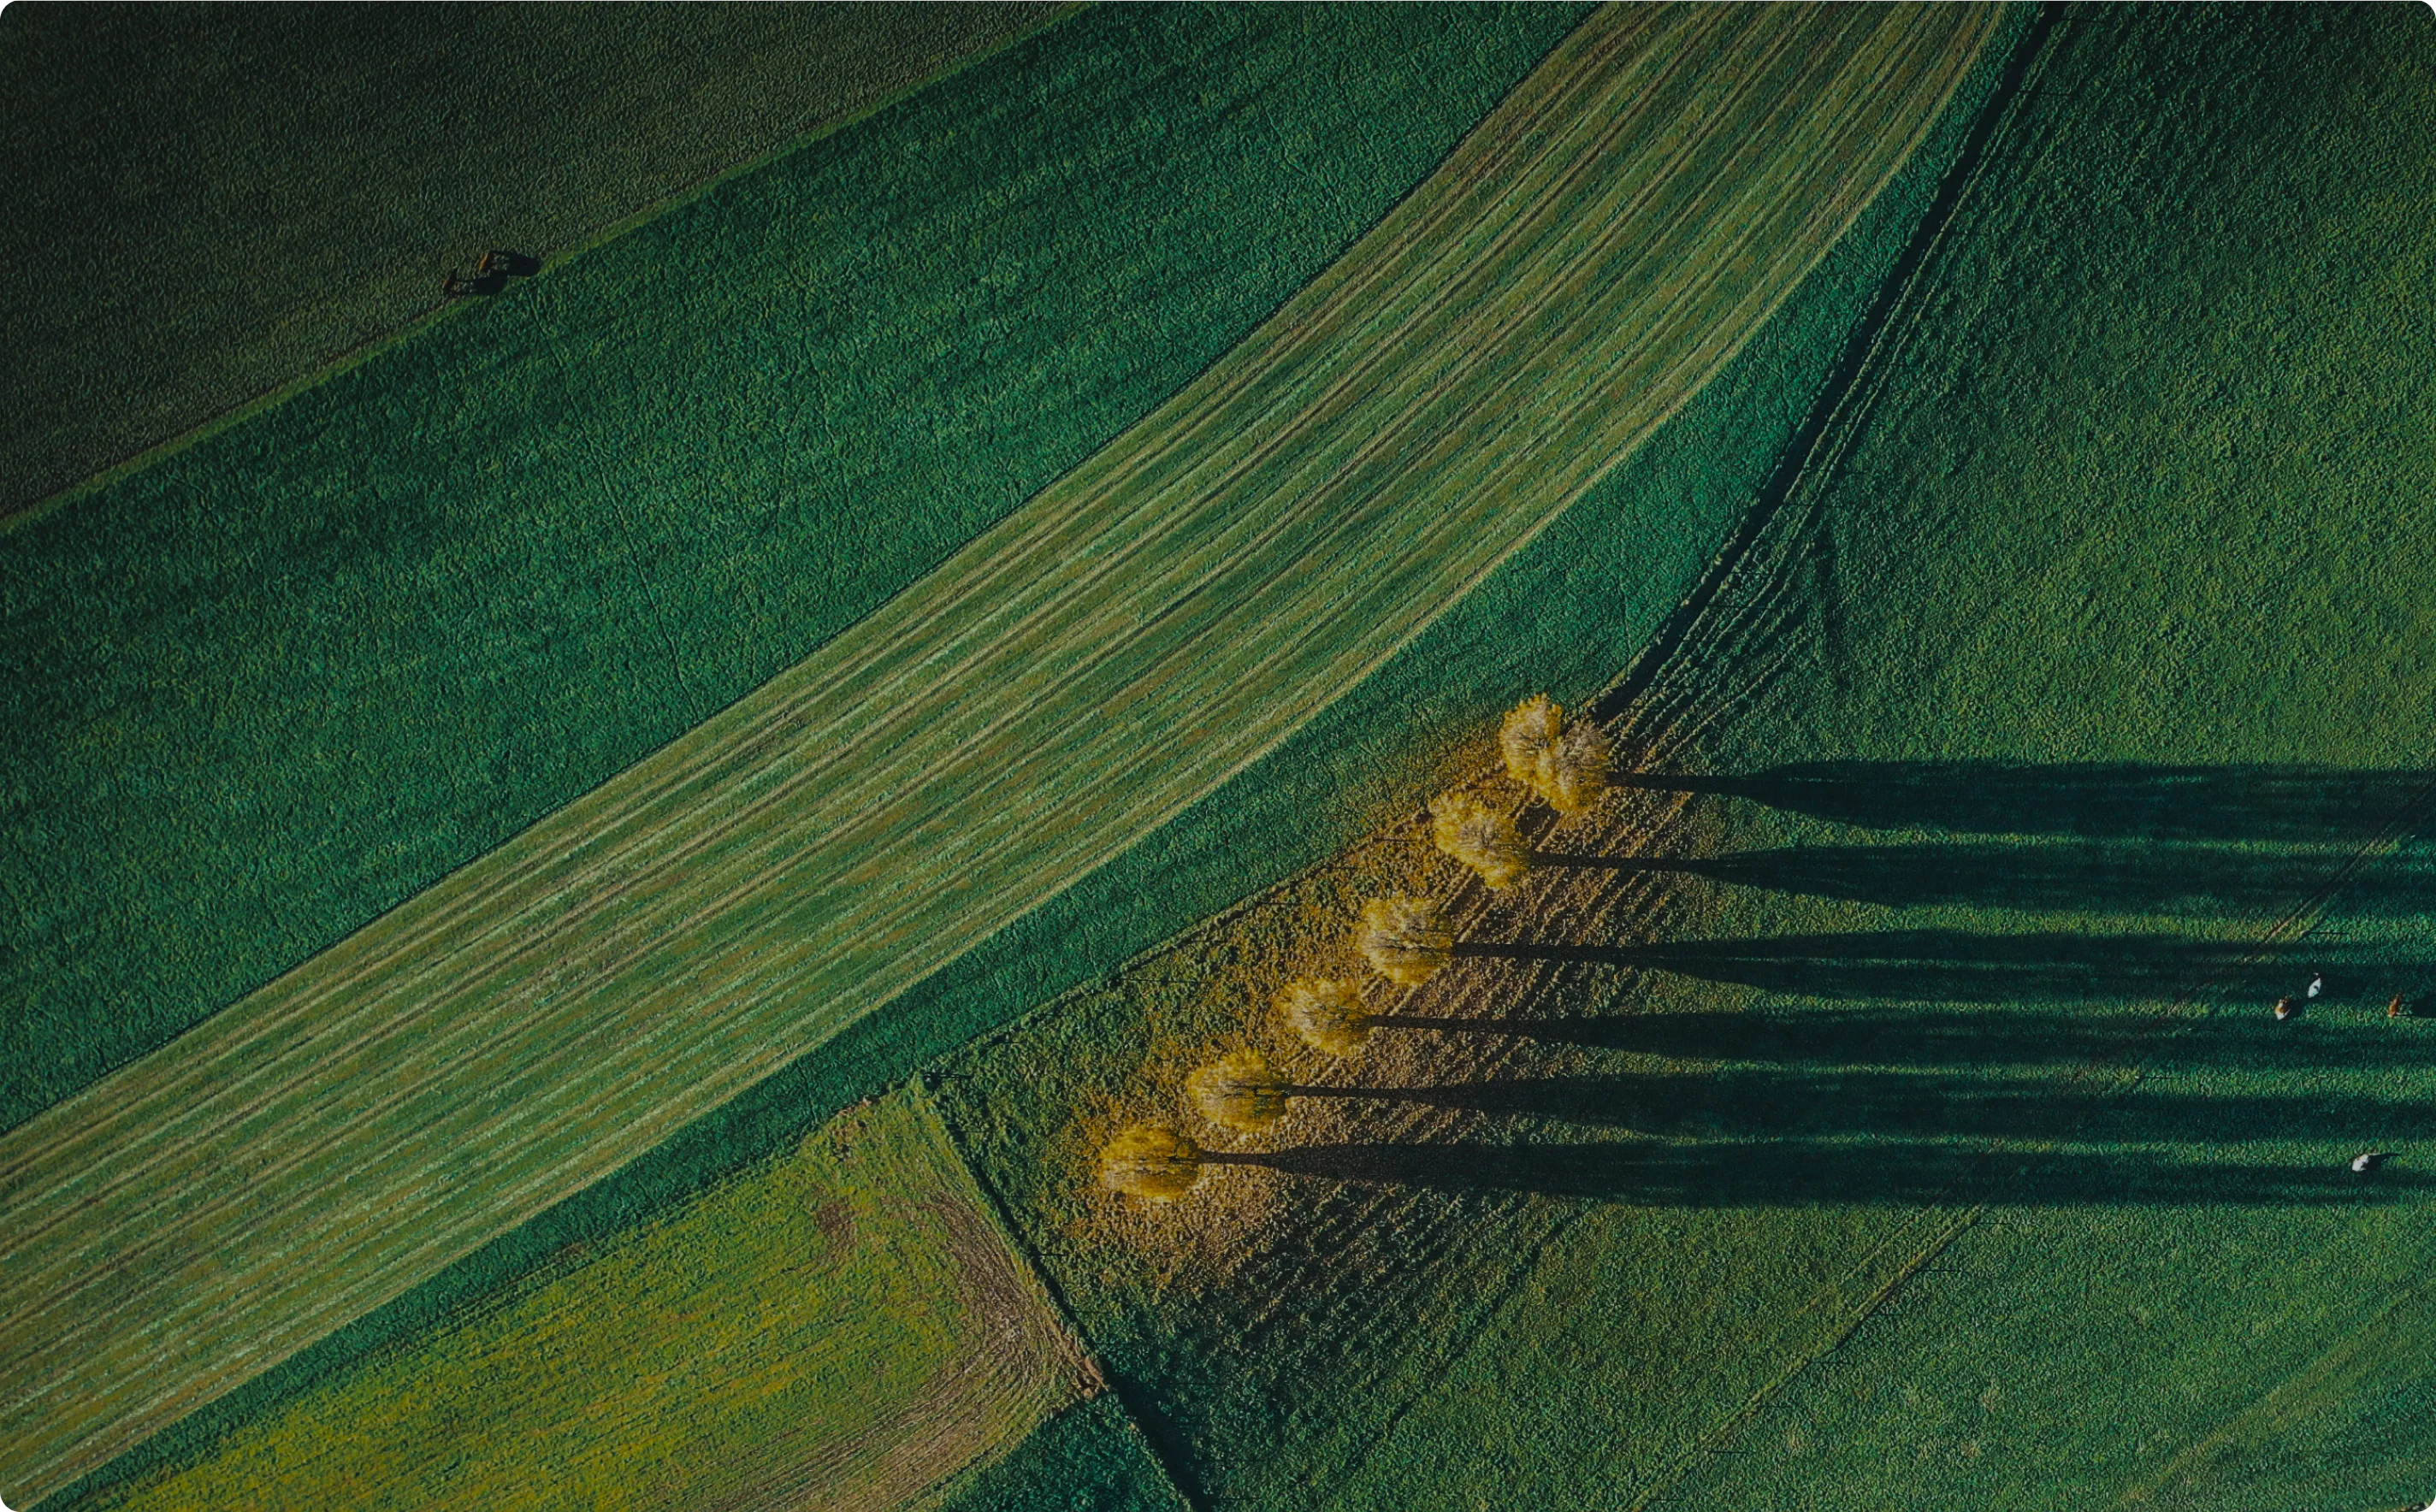
Gestreifte grüne Felder von oben, eine Baumreihe wirft in der Dämmerung lange Schatten

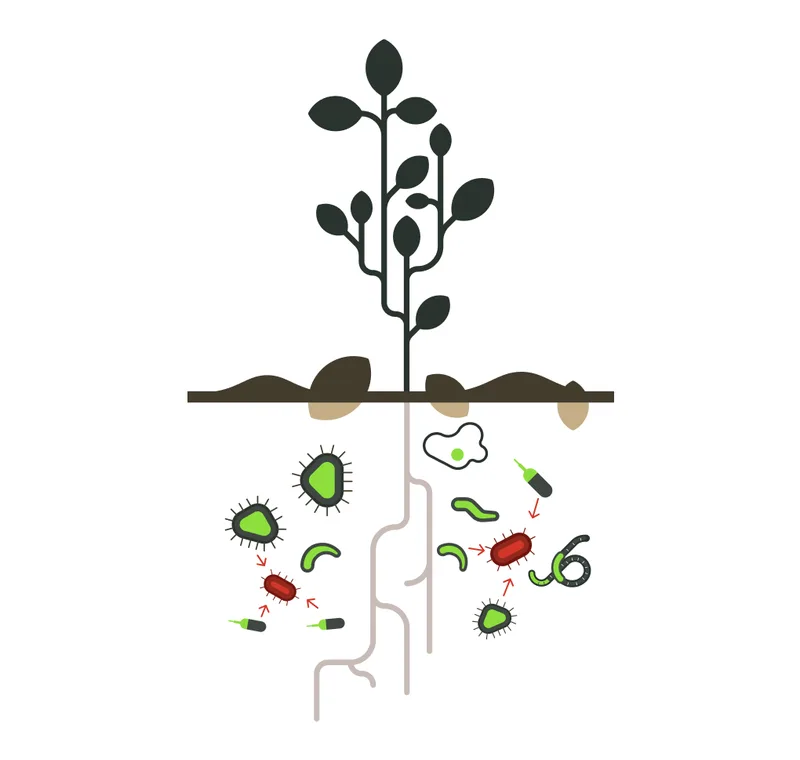
Die nächste Generation biologischer Pflanzenschutzmittel gibt es längst in der Natur.

Wir finden sie in krankheitsunterdrückenden Böden, rekonstruieren ihre Genome und durchsuchen sie nach neuen Wegen, Pflanzenkrankheiten zu bekämpfen.

DAS PROBLEM

20–30 % der Produktion wichtiger Kulturen gehen jedes Jahr durch Schädlinge und Krankheitserreger verloren.

Quelle: Savary et al., Nature Ecology & Evolution, 2019.

Der Pflanzenschutz braucht neue Wirkmechanismen.

Resistenzen nehmen zu. Etablierte Wirkstoffe verlieren ihre Zulassung. Neue Lösungen kommen nicht schnell genug.

Quelle: Pest Management Science, DOI 10.1002/ps.70522

Reife Weizenähren vor blauem HimmelÄHRENFUSARIOSE

Weizen

2,9 Mrd. $

geschätzter Verlust
Reihen von Sojapflanzen von oben, eine Fahrspur zieht sich hindurchSojabohnenrost

Soja

> 2 Mrd. $

Schaden pro Jahr
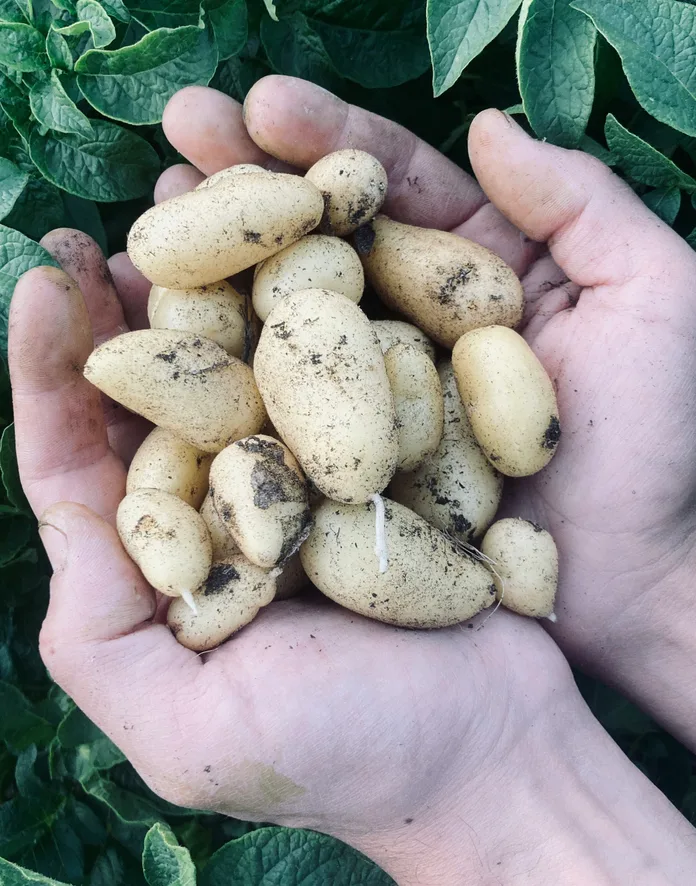
Zwei Hände halten frisch ausgegrabene KartoffelnKraut- und Knollenfäule

Kartoffel

~6,1 Mrd. $

Schaden pro Jahr
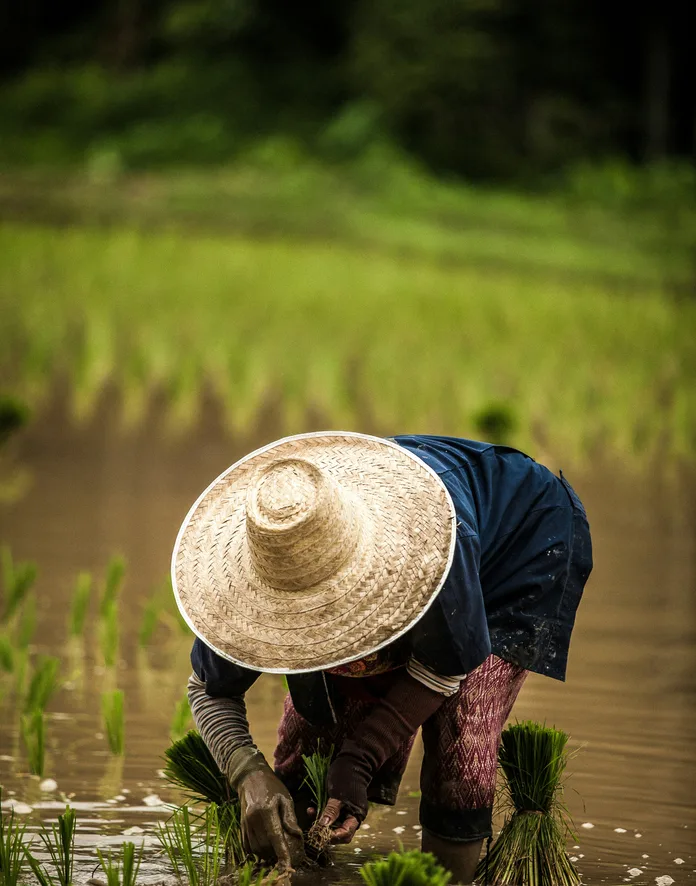
Ein Bauer mit Strohhut pflanzt Reis von HandReisbräune

Reis

> 2 Mrd. $

Schaden pro Jahr

Für uns beginnt One Health im Boden. Wir fangen bei gesünderen Kulturen und Böden an, aber unser Blick reicht weiter, über Pflanzen, Tiere, Menschen und Umwelt.

Pipeline
Felddaten zeigen, welche mikrobiellen Taxa mit Krankheitsunterdrückung verbunden sind.
DAS MODELL

LOAM ist das Fundament dieser einzigartigen Pipeline.

Eine Familie genomischer Sprachmodelle (gLMs), trainiert auf der DNA mikrobieller Bodengemeinschaften. Trainiert auf Hunderten Milliarden Tokens aus Tausenden Metagenomen, mit einem Kontextfenster für weitreichende biologische Wechselwirkungen und der passenden Rechenleistung.

Deep Learning
Ein DNA-Strang, gezeichnet als Wolke grüner Punkte
Die DNA lesen und die biologische Vielfalt in mikrobiellen Gemeinschaften kartieren.

Genome interpretieren

Ableiten, was Gene und biologische Systeme tun.

Antimikrobielle Stoffe finden

Peptide und Proteine finden, die Krankheitserreger hemmen könnten.

Kandidaten reihen

Die vielversprechendsten Sequenzen priorisieren.

Wirkstoffe entwerfen

Sequenzen für eine Zielaktivität erzeugen und optimieren.

BENCHMARK

Durchgängige Zugewinne in allen Benchmarks

Alle Modelle wurden mit demselben Korpus und Aufbau trainiert. Bei Varianteneffekt und Enzymfunktion steigt die Leistung mit der Modellgröße, bei der Gen-Essentialität flacht sie ab.

Wir ändern einen Buchstaben in einem bakteriellen Gen und prüfen, ob die Überraschung des Modells über die Änderung zu ihrer gemessenen Wirkung auf den Organismus passt.
macro Spearman0.000.050.100.150.200.250.300.3520M50M100M200M500M1B7BProkBERT-mini, 0.114ProkBERT-mini-c, 0.130LOAM-25M, 0.133LOAM-100M, 0.203NTv3-100M, 0.107GenomeOcean-100M, 0.172gLM2-150M, 0.065LOAM-340M, 0.271GenomeOcean-500M, 0.248LOAM-624M, 0.318gLM2-650M, 0.096Evo 1.5 (8k, 7B), 0.318Evo2-7B (residual stream), 0.342
  • LOAM-25M
  • LOAM-100M
  • LOAM-340M
  • LOAM-624M
  • Andere Modelle
Benchmark-Ergebnisse von dreizehn genomischen Sprachmodellen nach Parameterzahl
PARTNER
  • Google
  • NVIDIA
  • Universität Hamburg
  • Illumina
  • Oxford Nanopore Technologies
  • EuroHPC
  • LuxProvide
Updates
KONTAKT

Lassen Sie uns zusammenarbeiten.

Interesse an einer Partnerschaft oder daran, unsere Arbeit an Bioassets zu verfolgen? Nehmen Sie Kontakt auf oder melden Sie sich für Updates an.

Worum geht es?

Wir verwenden diese Angaben nur, um Ihre Anfrage zu beantworten. Mehr dazu in unserer Datenschutzerklärung.